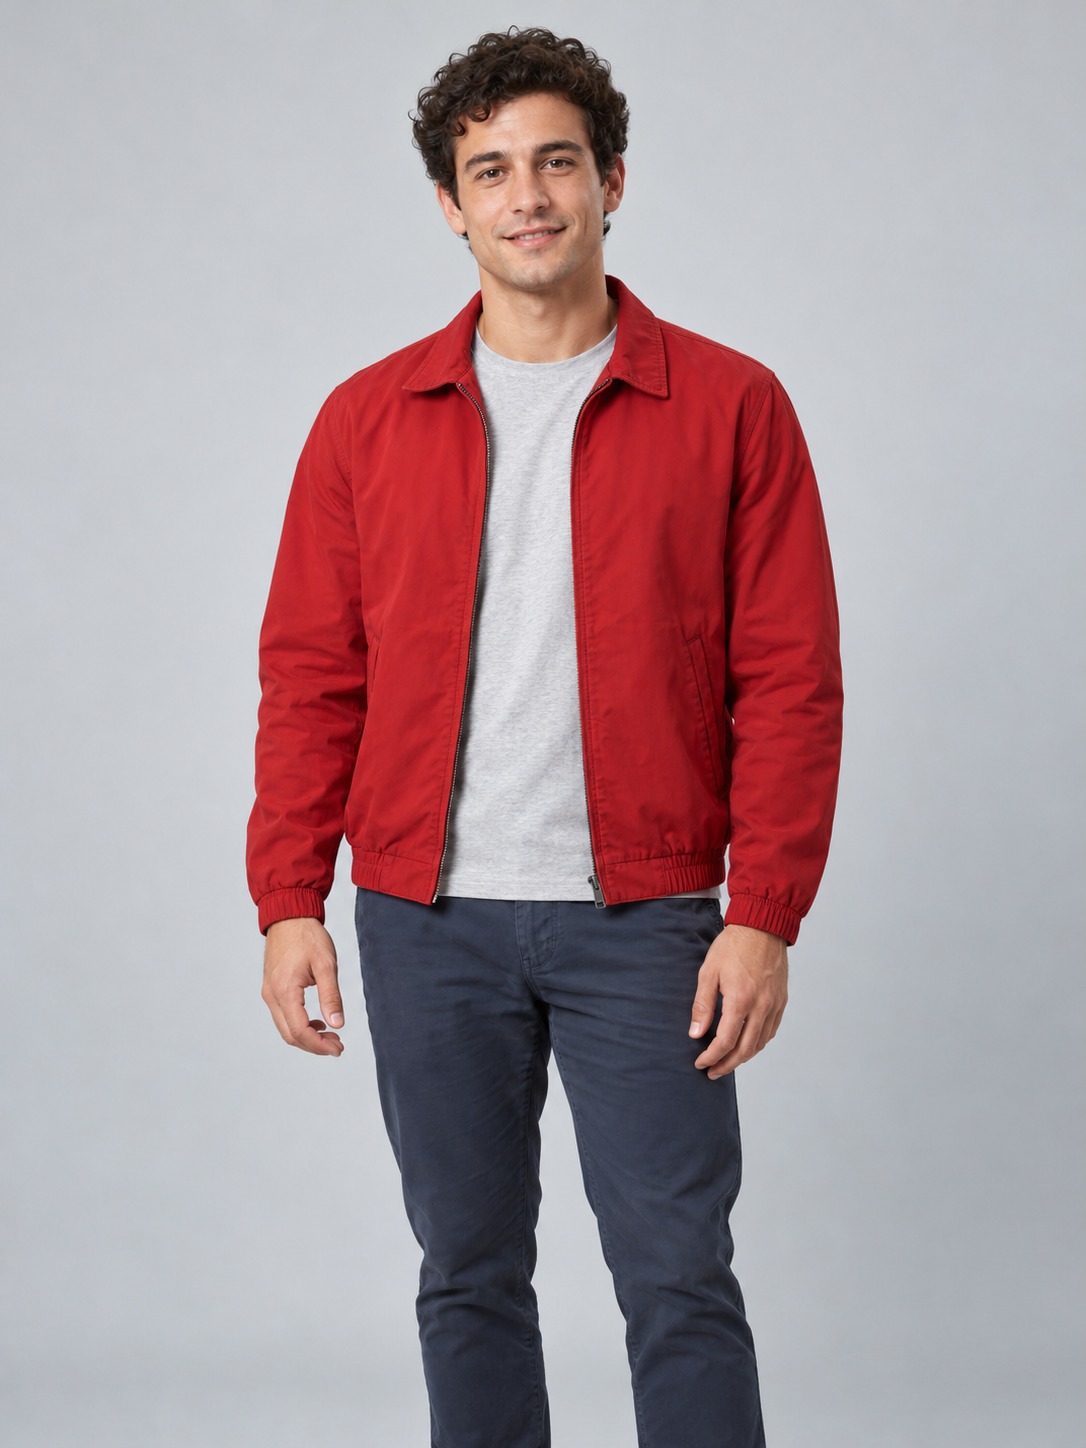
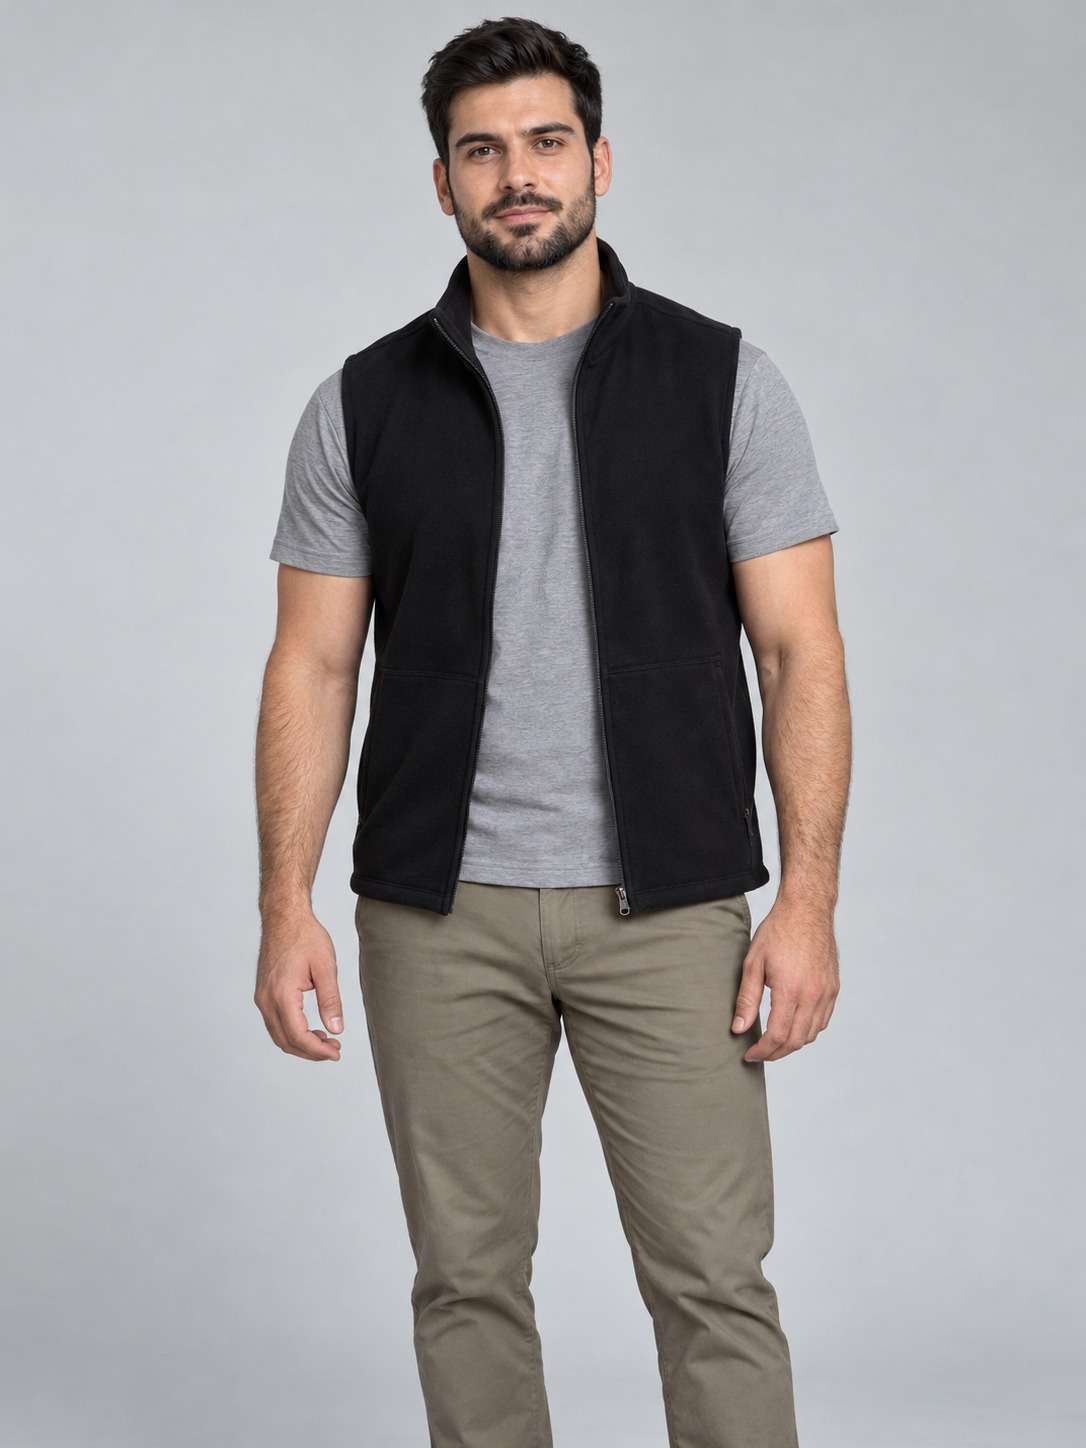
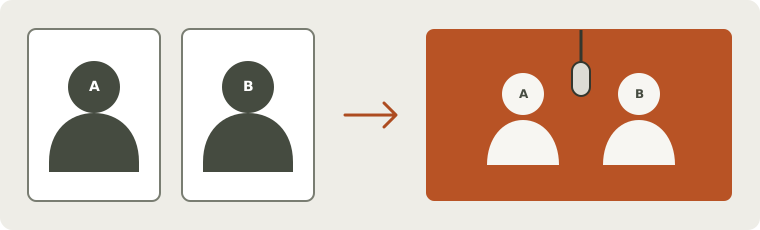
 输入布局示意图,不是人物照片或生成结果。
不用一起拍摄,也能准备双人草稿
两张分照应各有一位表演者:照片 1 对应左侧,照片 2 对应右侧。合照按原图左右顺序定位。尽量使用视线高度接近、面部无遮挡的素材,方便核对人物。
系统会检查照片中最多两位人、猫或狗。照片不清楚或对象太多时,会提示你核对或换图。生成后仍需检查人物面部。
同框、主唱与轮唱分别看待
可以准备轮流主唱,或一位主唱搭配互动伙伴。歌词可以共用,也可按左右两人分别填写。交换分照时,姓名、分配歌词和主唱位置也会一起交换。
这些设置用来指导谁领唱、唱哪些词。实际结果可能不同,请听完整段,并检查每次接唱时是谁在唱。
同框、主唱与轮唱分别看待| 设置 | 想实现什么 | 仍需检查什么 |
|---|
| 主唱加搭档 | 一边唱主词,另一边互动 | 搭档是否跟唱了整段 |
|---|
| 轮流主唱 | 双方短句回应 | 声音与嘴型是否在正确时刻切换 |
|---|
| 分配歌词 | 两边使用不同文字 | 实际字句是否属于指定人物 |
|---|
两个人共用同一段视频时长
先给每人写一句短句。双方歌词共用总时长和字数限制,不能每人都写满一条视频的量。姓名与发音也需要占用时间。
例如一人送出生日祝福,另一人接一句友好玩笑。这是写作方向,不是录制结果,也不是精准轮唱保证。
分享前同时检查两个人
成片后打开声音,听听姓名与歌词,看看两个人如何接唱和互动。喜欢的版本请在到期前下载保存。
提交前查看所选模型、时长和分辨率需要多少积分。保存草稿免费,工作室会提示能否生成。
真实生成案例
看看照片如何变成有声音的说唱表演。这些案例使用虚构成年人物,并附上各自的原始照片、文字和设置。
两张分照,两段分人歌词
表演观察与样片说明
已检查的内容
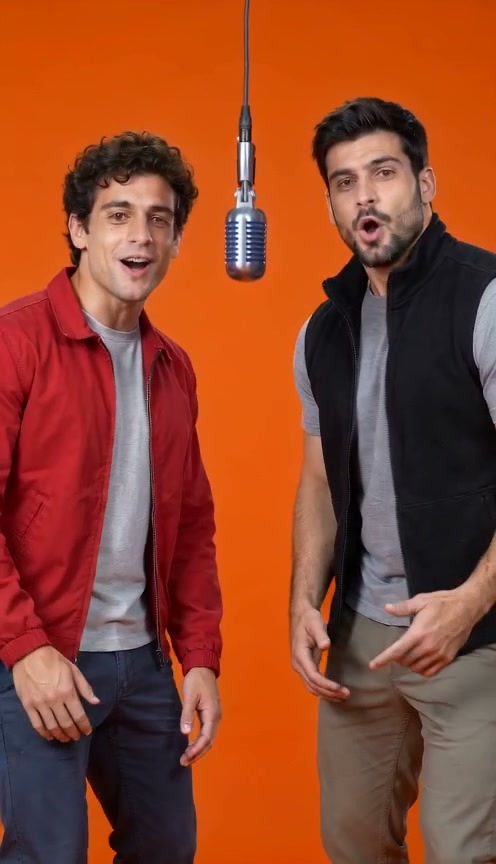
- 选用的是一次重做结果,与首轮使用相同的两张合成肖像及分人歌词;两位身份和左右顺序仍可辨认。
- 左侧主要表演完整前句,再由右侧接后句;Whisper 识别到两句原文,未再出现首轮的重复短句。
- 已检查原片播放、文件规格和基础音画对齐;本例不代表所有自定义双人生成均已验收。
本案例的边界
- 两人长时间将手指放在脸旁,动作较单一;离线检测在主唱片段估计约 120–160 毫秒偏差,嘴型并非精确同步。
- Vosk 把“bright”末尾截短,并在结尾额外识别到“it’s just”,Whisper 未识别到这些额外词。请以原片复听核对,两种识别都不能证明逐字无误。这只是英语/Orange Booth/Fast/720p/10 秒的一次重做。
离线识别的英语歌词
Alex brings the rhythm, Jamie brings the light Two good friends together make the moment bright
自动转写可能听错字词,请播放完整原片核对。用单张双人同框图生成
表演观察与样片说明
已检查的内容
- 本次实际只提交一个含两位合成成年人物的图片文件;抽查片段中,两人的左右顺序和可辨认身份保持一致。
- 前句主要由左侧表演,后句主要由右侧表演;离线基础音画检查支持这两个片段的对齐。
- Whisper 识别到原歌词,Vosk 将“light”识别为“lie”;完整视频已带声音播放,浏览器下载与保存原片一致。
本案例的边界
- 输入为已有 AI 视频的完整单帧,不是真人相机合照;不能据此验证所有真实合照。
- 转写存在分歧,互动时偶有嘴部运动,不能据此保证逐字演唱或严格的逐词发声人物对应。这只是英语/Orange Booth/Fast/720p/10 秒的一次结果。
离线识别的英语歌词
Alex brings the rhythm Jamie brings the light two good friends together make the moment bright
自动转写可能听错字词,请播放完整原片核对。开始前你可能想问
两张照片可以分开拍吗?
可以,各准备一张清晰人物照,不需要一起录制。
一张情侣合照能用吗?
可以,前提是两个人都清晰可见。合照与分开上传的照片可能产生不同效果,生成后请核对两个人的脸和表演。下方案例使用的是 AI 合成双人图,并非相机拍摄的真人合照。
能准确指定每人说哪一句吗?
可以分配文字并请求轮唱,但声音区分、逐字还原与接唱顺序需要核对实际结果。
能让两张照片一起唱完整歌曲吗?
本站专注短说唱表演。双人设置不代表完整歌曲和声,也不代表准确表演上传的整首歌曲。