Prepara foto e parole, poi verifica impostazioni disponibili e crediti nello studio. Salvare una bozza non consuma crediti.
Schema degli input: non sono foto né un risultato generato.
Non serve girare insieme
Servono una foto chiara per persona, il permesso di usarle e un’idea breve. Un augurio o una battuta condivisa entra meglio in un breve video rispetto a una conversazione intera. Puoi anche preparare una foto insieme, ma quel risultato richiede una verifica propria.
Lo studio rileva fino a due persone, gatti o cani. Se la foto è poco chiara o contiene troppi soggetti, ti chiederà di controllarla o cambiarla. Controlla anche i volti nel video finale.
Una scena, ruoli diversi
Le voci alternate chiedono uno scambio di frasi. Una voce principale con accompagnatore chiede a una persona di rappare mentre l’altra reagisce. Due persone visibili non dimostrano due voci principali.
Queste impostazioni indicano chi guida e quali parole canta. Il risultato può variare: ascolta entrambe le parti e osserva chi canta a ogni passaggio.
Una scena, ruoli diversi
Impostazione
Intenzione
Che cosa controllare
Voce principale e partner
Una persona rappa; l’altra reagisce
Che il partner non canti tutto il testo
Alternanza
Un breve scambio
Che voce e bocca cambino al momento previsto
Testi assegnati
Un testo per persona
Che le parole corrispondano all’interprete
Le due persone condividono lo stesso tempo
Inizia con una frase breve per persona. Entrambe condividono durata e limite totale di parole. Il limite d’ingresso è di tre parole conteggiate al secondo, non una garanzia di dizione naturale.
Inserisci il nome nel testo se deve essere pronunciato. Una nota può orientare la pronuncia senza garantirla. Un esempio scritto resta una proposta, non una registrazione verificata.
Controlla entrambi prima di condividere
Guarda il risultato con il suono. Ascolta nomi e parole e osserva come partecipano le due persone. Scarica la versione che ti piace prima della scadenza.
Controlla i crediti per modello, durata e risoluzione prima dell’invio. Salvare una bozza è gratuito; lo studio mostra l’accesso alla generazione.
Esempi realmente generati
Esplora esibizioni complete create con adulti immaginari nello studio. Ogni video presenta foto, parole e impostazioni originali.
Due ritratti, due frasi assegnate
Immagini di riferimento
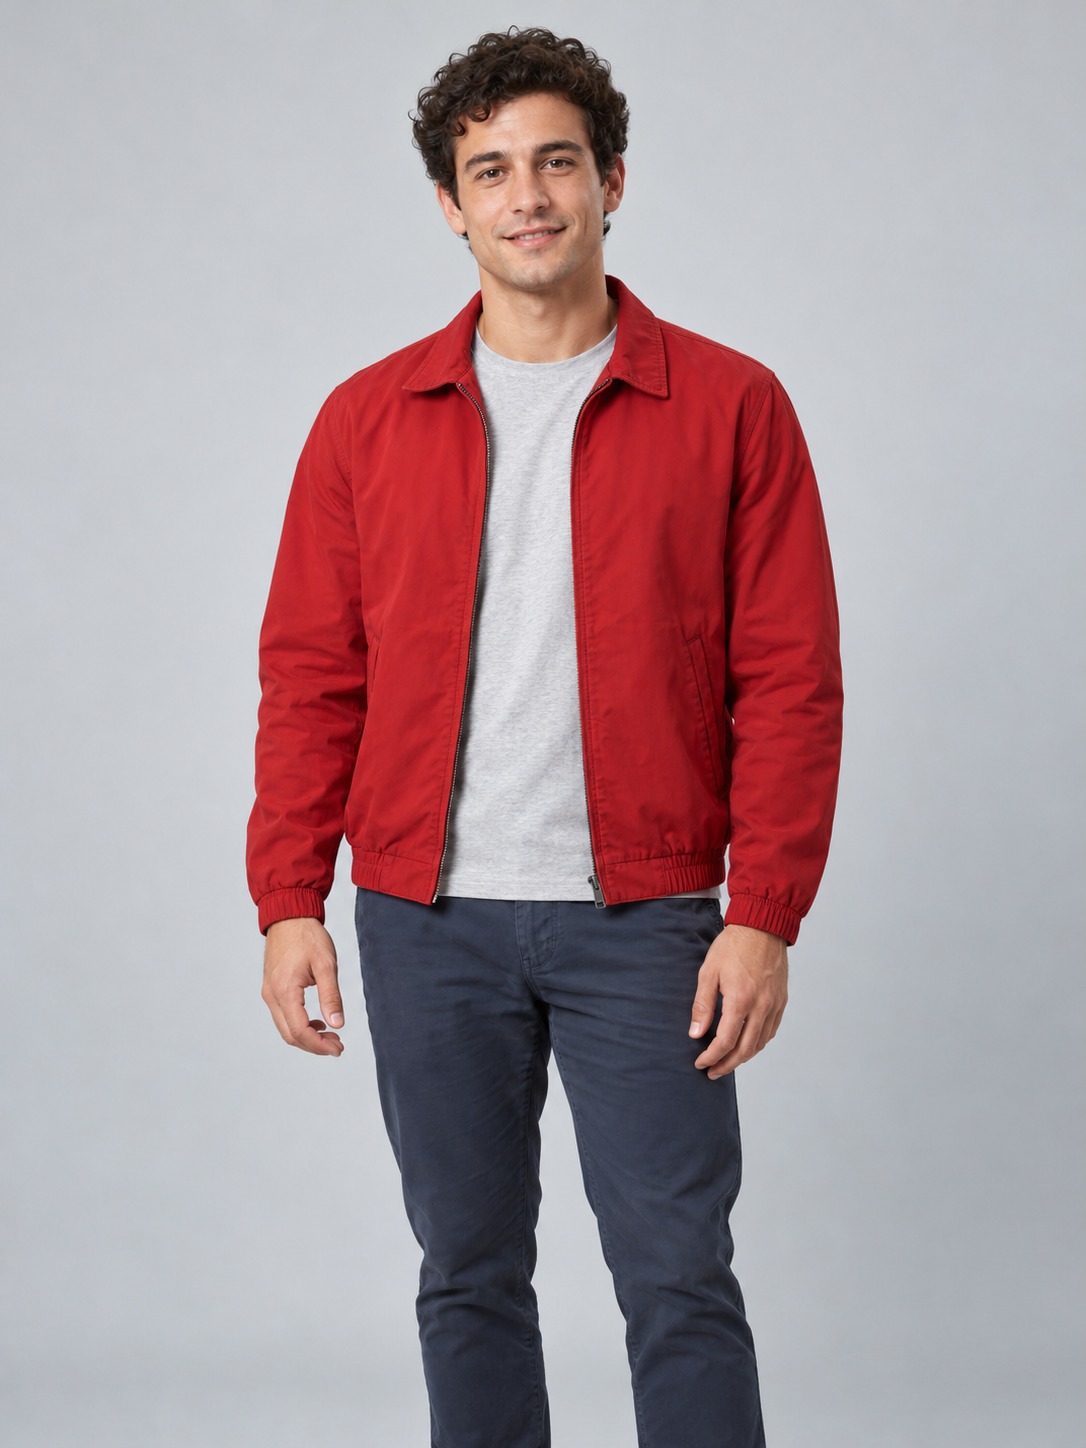
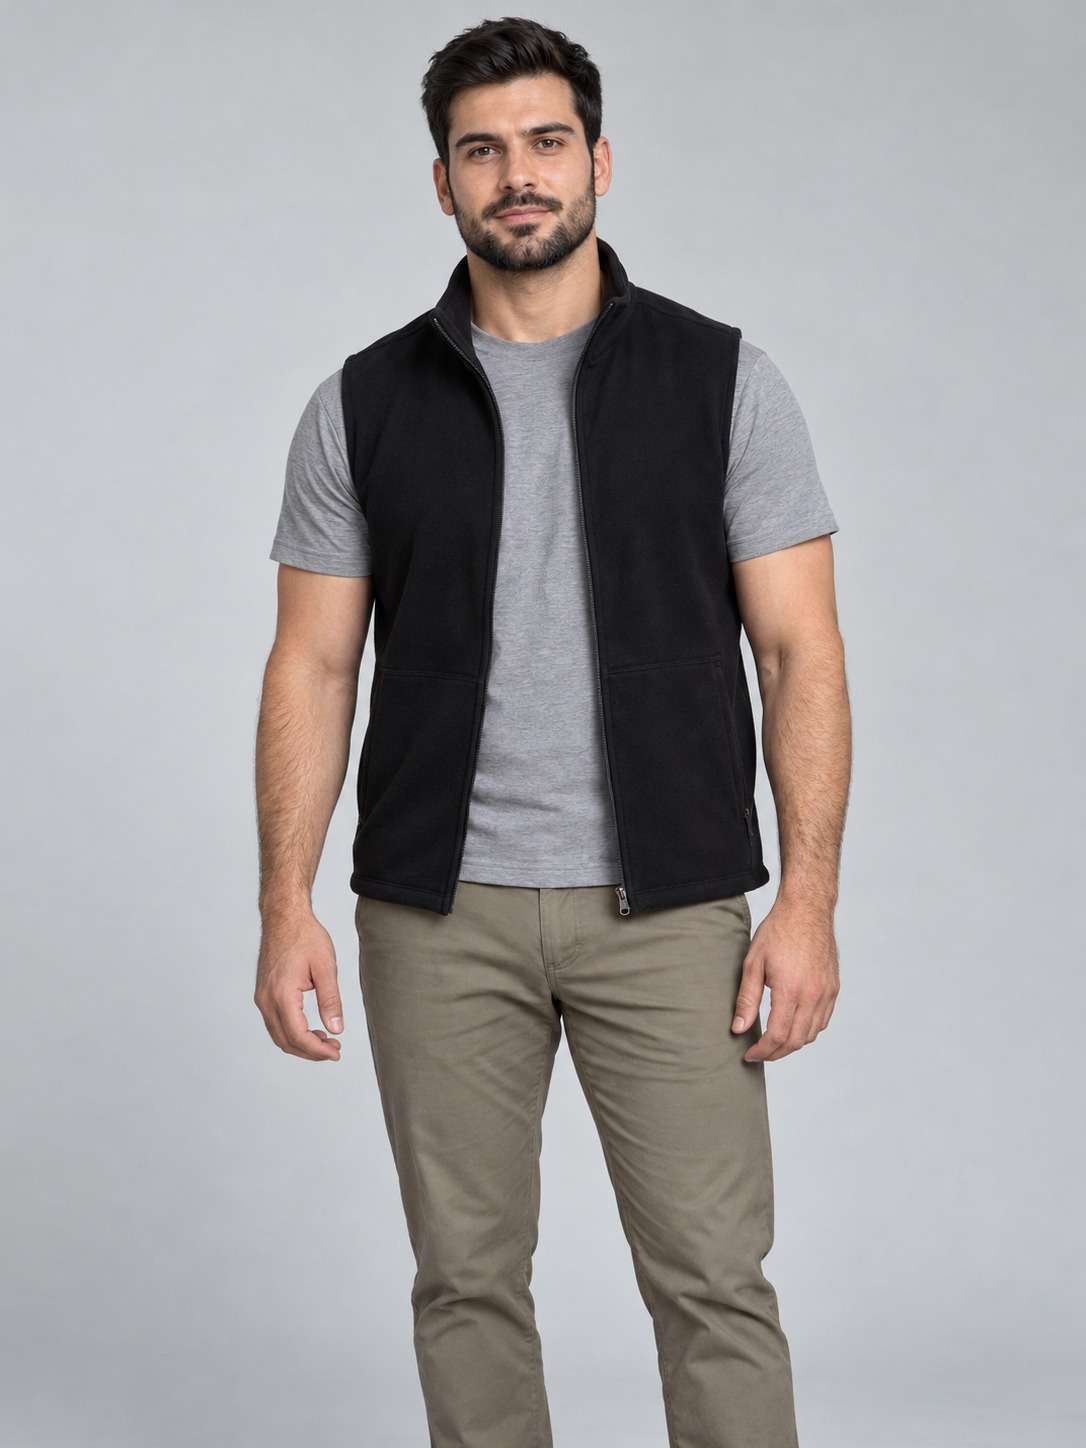
Foto 1 / sinistraFoto 2 / destra
Ritratti originali di adulti immaginari generati con IA.
Testo originale richiesto in inglese
Alex: Alex brings the rhythm, Jamie brings the light.
Jamie: Two good friends together, make the moment bright.
È mostrato l’unico nuovo tentativo, con gli stessi due ritratti sintetici e le stesse righe assegnate. Le due identità e il loro ordine rimangono riconoscibili.
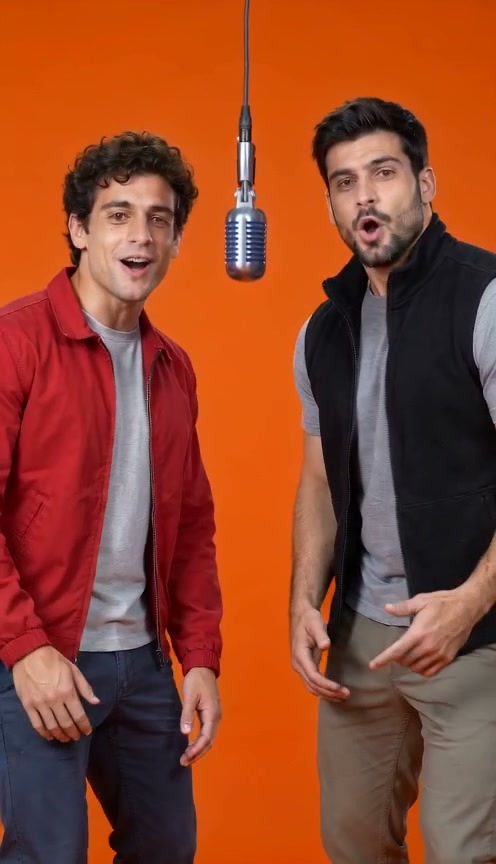
L’interprete a sinistra esegue soprattutto la prima riga completa, seguito da quello a destra. Whisper ha riconosciuto entrambe senza la ripetizione del primo tentativo.
Sono stati controllati riproduzione, specifiche e allineamento audiovisivo di base. Questo esempio non convalida ogni generazione personalizzata con due persone.
Limiti dell’esempio
Entrambi tengono un dito vicino al viso per gran parte del video e si muovono poco. L’analisi locale stima circa 120–160 ms di scarto nei tratti principali; la sincronizzazione non è esatta.
Vosk tronca “bright” e aggiunge “it’s just” alla fine, mentre Whisper no. Confronta l’audio originale: nessuna trascrizione prova la fedeltà parola per parola. È un nuovo tentativo in inglese / Orange Booth / Fast / 720p / 10 s.
Trascrizione locale in inglese
Alex brings the rhythm, Jamie brings the light Two good friends together make the moment bright
La trascrizione automatica può sbagliare. Riproduci la registrazione completa per confrontare.
Due interpreti da un’immagine condivisa
Immagini di riferimento
Un file con entrambe le persone
Un fotogramma intero di un precedente video IA: un’immagine sintetica con due persone.
Testo originale richiesto in inglese
Alex: Alex brings the rhythm, Jamie brings the light.
Jamie: Two good friends together, make the moment bright.
È stato inviato un solo file con due adulti sintetici; volti riconoscibili e ordine sinistra/destra restano coerenti nelle sequenze controllate.
L’interprete a sinistra guida soprattutto la prima riga e quello a destra la seconda; è stato controllato l’allineamento audiovisivo di base di questi tratti.
Whisper ha riconosciuto il testo richiesto; Vosk ha interpretato “light” come “lie”. Il video è stato riprodotto con audio e il download coincide con l’originale salvato.
Limiti dell’esempio
La fonte è un fotogramma completo di un precedente video IA, non una foto di gruppo scattata con una fotocamera. Non convalida ogni foto reale.
Le divergenze nelle trascrizioni e alcuni movimenti della bocca durante le reazioni impediscono di garantire ogni parola o la sua esatta attribuzione. È un risultato in inglese / Orange Booth / Fast / 720p / 10 s.
Trascrizione locale in inglese
Alex brings the rhythm Jamie brings the light two good friends together make the moment bright
La trascrizione automatica può sbagliare. Riproduci la registrazione completa per confrontare.
Domande prima di iniziare
I ritratti possono essere scattati separatamente?
Sì. È possibile preparare una foto indipendente per persona; non c'è bisogno di registrare insieme.
Posso usare una foto di una coppia?
Sì, se entrambe le persone sono ben visibili. Una foto insieme e due ritratti possono dare risultati diversi; controlla volti ed esibizione. L’esempio qui sotto usa un’immagine sintetica di due persone, non una fotografia scattata con una fotocamera.
Posso controllare esattamente chi dice ogni linea?
È possibile assegnare parole e richiedere lead alternati. Separazione vocale esatta, formulazione e ordine di turno sono controlli di output, non garanzie dalle impostazioni di testo.
Due foto possono cantare una canzone intera insieme?
Questo prodotto si concentra sulle prestazioni rap brevi. I controlli Duo non stabiliscono l'armonia della canzone completa o le prestazioni esatte di una canzone caricata.